

日本語、英語、ベトナム語、その他の言語で動作するLLMを評価する際、回答が文法的に正しいかを見るだけでは十分ではありません。出力された文章が非常に自然に読めても、質問の意図を誤解していたり、要求を一部見落としていたり、用語を誤って使っていたり、対象市場のコミュニケーションの慣習に合っていなかったりすることがあります。そのため、LLM 多言語評価データは、実際のユーザーが遭遇する状況を適切に検証できるよう設計する必要があります。また、企業は誰がレビューするのか、どの基準で評価するのか、複数のレビュアーの判断が分かれた場合にどう処理するのかも明確にしなければなりません。最終的な目的はサンプル数を増やすことではなく、モデルが正しく処理できる分野は何か、またはどこで誤りが発生するのかを把握できるデータセットを作ることです。
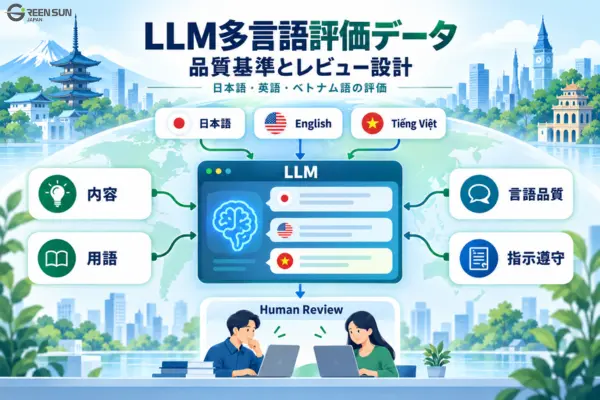
1. LLM 多言語評価データにはどのようなサンプルが必要か?
多言語LLMの評価データを設計する際は、まず、モデルの用途と企業が検出したいエラーの種類を明確にする必要があります。カスタマーサポート用チャットボット、翻訳ツール、コンテンツ作成支援、文書Q&Aシステムでは、それぞれ求められる品質や検出すべきエラーが異なるため、用途に応じたテストセットを用意する必要があります。
英語の質問セットをそのまま他言語へ翻訳するだけの方法は推奨されません。比較のために共通利用できるケースもありますが、言語ごとに呼称、丁寧さ、用語、背景事情が異なります。MLCommonsは、言語、文化的背景、実際のユーザーとAIのやり取りをより適切に反映するため、多言語・多文化ベンチマークを開発しています。そのため、共通サンプルに加え、対象言語や市場ごとに作成・調整したサンプルもデータセットへ組み込むことが重要です。
データセットは、例えば次のように分類できます。
| サンプルの種類 | 確認すべき点 |
|---|---|
| 一般的な質問 | 意図を正しく理解し、要点に沿って回答しているか |
| 複数条件を含むプロンプト | 各条件をすべて実行しているか |
| 専門分野の内容 | 用語と表現が正確か |
| ニュアンスを含む内容 | 丁寧さ、含意、文脈が適切か |
| 形式指定 | 表、箇条書き、JSON、指定構造を守っているか |
| 誤解しやすい状況 | 推測、情報追加、意図の取り違えがないか |
評価データを収集・ラベル付けする際は、各サンプルに対象言語と市場、利用場面、評価対象となる入力、評価基準、ラベリングガイドライン、検出すべきエラーの種類を明記することが望まれます。これにより、レビュアーが同じ目的を理解したうえで判定でき、評価結果が異なった場合も原因を追跡しやすくなります。
実例:
・日本語メールが内容自体は正しくても、表現が直接的すぎる場合、適切性の評価では不合格となる可能性があります。
・ベトナム語の回答が情報として正しくても、プロンプトに含まれる3つの要求のうち2つしか実行していない場合、指示遵守のエラーとして記録する必要があります。
・技術文書の出力が流暢でも、部品名や専門用語を誤って使用している場合はエラーとしてマークする必要があります。
LLM 評価データ作成で重要なのは、各サンプル群に明確な評価目的を持たせることです。似た内容のサンプルを大量に含めても、検出できるエラーの種類が広がらなければ、必要なリスクを的確にカバーする小規模なデータセットより価値が低くなる場合があります。
2. 多言語 QAでは何を評価すべきか?
2.1 多言語QAルーブリックに必要な評価項目
多言語 QAでは、レビュアーに単に「良い」「悪い」と総合的な評価をさせるのではなく、評価項目と採点方法が明確なルーブリックを使用することが重要です。ルーブリックはモデルの利用目的と、企業が検出したいエラーの種類に合わせて設計する必要があります。チャットボット、Q&Aシステム、コンテンツ生成ツール、構造化出力では、各評価項目の重要度が異なるためです。
ルーブリックには、例えば次の項目を含められます。
・内容の正確性:質問を誤解していないか、不適切な情報を提示していないか。
・完全性:重要な要求を見落としていないか。
・関連性:冗長な回答や、本題から外れた内容がないか。
・言語品質:文法、語彙、表現が自然か。
・用語:専門用語、固有名詞、呼称が正確かつ一貫しているか。
・指示遵守:指定された言語、形式、長さ、構造を守っているか。
・文脈適合性:トーンや表現が対象ユーザーに適しているか。
すべてのプロジェクトで、すべての評価項目を同じ重みで適用する必要はありません。例えば、JSON出力を生成するタスクでは構造と形式の遵守を優先する必要があります。一方、カスタマーサポート向けチャットボットでは、意味の正確性、表現、ユーザーへの適切性をより重視することが一般的です。
2.2 データセット全体を評価する前にレビュー方法を標準化する
ルーブリックは、レビュアーが各評価項目を同じように理解して初めて有効に機能します。データセット全体のレビューを開始する前に、採点方法、エラーのレベル、再評価が必要なケースを明確に定め、レビュアーごとに異なる基準が適用されることを防ぐ必要があります。
米国国立標準技術研究所(National Institute of Standards and Technology:NIST)のNIST AI Risk Management Frameworkでは、AIリスクの評価に定量的手法、定性的手法、またはそれらを組み合わせた手法を利用できるとしています。また、システムの導入前だけでなく、運用中も継続的にテストを実施することを推奨しています。さらに、独立した評価プロセスを設けることで、テストの有効性を高め、内部バイアスや潜在的な利益相反の影響を抑えられる可能性があるとしています。
レビュー開始前のチェックリスト:
・各評価項目と採点方法を定義する。
・Pass/Failの例、または各スコアレベルの例を用意する。
・重大なエラーに該当する条件を明確にする。
・2回目のレビューが必要なケースを定める。
・複数の回答がいずれも妥当な場合の扱いを統一する。
・レビュアーが対象言語と分野に適しているか確認する。
・小規模なサンプル群で試行し、曖昧なガイドラインを洗い出す。
本格的な評価を開始する前に、小規模なサンプル群でルーブリックを調整することが有効です。複数のレビュアーが同じ種類の回答で繰り返し判断を分ける場合は、評価項目の定義、ガイドラインの例、スコア間の境界を見直す必要があります。この段階でガイドラインを調整することで、データセット全体へ適用した際の評価結果をより一貫させやすくなります。
3. なぜLLM human reviewが必要なのか?
LLM human reviewは、出力品質が文脈や実際の言語使用に左右される場合に必要です。特に、次のような要素は自動指標だけでは十分に測定しにくいものです。
・自然さ:文法的に正しくても、硬い表現や、母語話者が通常使わない表現になっている場合があります。
・ニュアンスと丁寧さ:呼称、トーン、フォーマル度が対象ユーザーに合っていない場合があります。
・文脈に応じた用語:言語としては正しい単語でも、特定の分野や文書種別では誤っている場合があります。
・市場への適合性:同じ内容でも、言語、国、対象ユーザーによって適切な表現が異なる場合があります。
例えば、日本語として文法的に完全に正しい文章でも、日本企業が通常使うコミュニケーション表現とは異なることがあります。同様に、専門用語が自然に見えても、技術文書では不適切な用語である場合があります。こうしたケースは、対象言語や専門分野を理解するレビュアーでなければ見抜きにくいことがあります。
LLM human reviewと他の検証方法を組み合わせることは、単一の指標だけに依存せず複数の方法でAIを測定・評価するというNISTの考え方にも沿っています。
4. レビュー体制はどのように設計すべきか?
レビュー体制は、サンプルの難易度とリスクに応じて分け、深い確認が必要なケースへリソースを集中できるように設計することが重要です。
ワークフローの例:
LLMを実行 → レビュアーがルーブリックに基づいて採点 → QA確認 → 判断の不一致を処理 → エラーを集計
次の方法を組み合わせられます。
・Single review:明確なサンプルを1人のレビュアーが処理する。
・QA sampling:QA担当者が一定割合のサンプルを再確認する。
・Double review:難易度が高い、主観的、または高リスクのサンプルに使用する。
・Adjudication:2人のレビュアーが一致しない場合に、3人目のレビュアーが判断する。
評価者間で判断が分かれたケースは、評価項目とエラー種別ごとに記録する必要があります。同じ種類の不一致が繰り返される場合は、次の評価ラウンドに入る前に、ルーブリック、用語集、ガイドラインを見直すことが重要です。
5. まとめ
多言語AIの品質を評価するには、実際の利用場面と検出したいエラーから設計を始める必要があります。データセットには必要な種類のサンプルを揃え、ルーブリックによってレビュアーが一貫して採点できるようにし、QAでは入力データとレビュー結果の両方を確認します。自然さ、ニュアンス、用語、地域固有の文脈では、人による評価が引き続き重要です。LLM 評価データ作成からAdjudication(評価者間の判断の不一致を解消するプロセス)までの流れを明確にすることで、評価結果を分析しやすくし、モデル改善にも活用しやすくなります。
6. FAQ
1. 英語のデータセットを多言語に翻訳するだけでLLMを評価できますか?
翻訳データの一部を共通サンプルとして利用することはできますが、それだけに依存することは推奨されません。各言語には、対象ユーザーの実際のコミュニケーション方法、用語、利用文脈を反映したケースを追加する必要があります。
2. レビュアーにはAIやプログラミングの知識が必要ですか?
すべてのレビュアーにプログラミングの知識が必要なわけではありません。多くのタスクでは、対象言語、ガイドライン、評価基準を十分に理解していることのほうが重要です。専門分野のデータでは、用語と内容を確認できる分野知識を持つレビュアーが必要になる場合があります。
3. 別のLLMですべての出力を自動採点できますか?
LLMはスクリーニングや評価規模の拡大に活用できますが、その採点方法が適切かどうかを事前に検証する必要があります。ニュアンス、文化、専門用語、複数の妥当な回答に関わる評価項目では、引き続き人による確認が必要になることがあります。
4. 2人のレビュアーの評価結果が異なる場合はどうすればよいですか?
まず、原因が出力そのものにあるのか、ガイドラインが不明確なことにあるのかを確認します。難しいサンプルは3人目のレビュアーによるAdjudicationへ回せます。同じ種類の不一致が繰り返される場合は、ルーブリックやガイドラインの例を追加する必要があります。
5. QAではデータセットのどの程度を確認すべきですか?
QAの割合は、難易度、リスク、レビュアーの安定性によって異なります。すべてのプロジェクトに固定割合を適用するのではなく、新しいレビュアー、判断が難しいエラー群、重要度の高いデータでは確認範囲を増やし、実際の結果に応じて調整できます。
Green Sun Japanのサービス
AIプロジェクト向け多言語コンテンツの準備
複数市場でAI製品やAIコンテンツを展開する場合、プロンプト、ガイドライン、用語集、参考資料の言語品質は、開発とテストのプロセスに直接影響する可能性があります。
Greensun Japanは、企業の多言語対応を次のように支援します。
・多形式の翻訳・ローカライズ – 文書、Webサイト、ソフトウェア、アプリケーション、関連コンテンツに対応します。
・3段階の品質チェックプロセス – 内容、用語、文脈、形式、一貫性を確認します。
・メール対応 – 要件の確認やプロジェクト範囲の整理をサポートします。
企業は、文書、用語集、ガイドライン、またはローカライズが必要なコンテンツを送付することで、Greensun Japanに対応範囲の確認と適切な進め方の提案を依頼できます。